2026年9月8日
作者:Shubhii Verma
下一場圍繞人工智慧的重大角力,或許不在於誰能生成最出色的內容,而是要如何證明這些內容的來源。
一張照片可以透過AI模型改寫;新聞記者的報導可能成為聊天機器人回答內容的一部分;藝術家的作品也可能影響一幅看似全新生成的圖像。隨著AI生成的文字、圖像、音樂與影片愈來愈難和人類創作區分,數位世界正面臨一項根本難題:當一件作品可能來自數十個看不見的人類與機器共同貢獻時,我們該如何建立一套可信的創作歷程紀錄?
這個問題的答案,將決定誰能獲得創作榮譽、誰可以取得報酬,以及發生著作權爭議時,該由誰承擔責任。
何謂AI內容來源溯源,其重要性為何?
對創作者而言,溯源的核心價值是明確責任歸屬。一套可驗證的紀錄,能夠更輕易地確認作品的誕生時間、創作者、修改歷程,以及適用的授權條款。對AI企業來說,溯源可提供一套框架,用以記錄訓練數據,並證明內容是在合乎規範的條件下取得。對於平台方,溯源則可用來分辨真實原創內容,與遭竄改、錯誤歸屬的內容。
密碼學溯源是可行的基礎方案之一。像是C2PA內容憑證這類標準,會把數位簽署紀錄附加在數位資產上,記錄作品來源、編輯歷程以及創作所使用的工具。密碼雜湊值會將紀錄與內容綁定,一旦遭到未授權竄改就會被偵測出來。C2PA也支援「軟綁定」技術,包含隱形浮水印與指紋辨識;當檔案的中繼資料遺失時,仍可藉此重新還原溯源資訊。
這也讓溯源機制遠比單純標示「AI生成」更有價值。想像一張圖片:原始是一張照片,經過人類編輯,再交由AI模型處理,接著進行後續潤飾,最後由新聞機構對外發布。溯源紀錄就能完整保存這整條演變鏈。
為何AI訓練數據歸屬仍困難重重
然而上述方案僅解決部分問題。就算知道圖片經過AI處理,依然無法得知是哪些訓練素材影響了模型。訓練數據的歸屬辨識難度相當高,現代模型從龐大數據集學習模式,卻不會保留簡單的「來源對輸出」對應關係。開發者或許清楚訓練的輸入資料,卻無法證明某張特定照片,對某一則生成輸出造成多少可量化的影響。
這項差異對著作權來說至關重要。美國著作權局指出:若人類創意充分決定作品的表達內涵,AI協助產出的作品可受到著作權保護;僅靠提示詞生成的內容,通常不足以構成足夠的人類創作資格。與此同時,使用受著作權保護的素材訓練生成式AI所引發的種種爭議,至今仍懸而未決。
AI著作權訴訟升高利害關係
相關爭議正從政策辯論,陸續走進法庭。2026年7月,Anthropic與作家、出版商達成價值15億美元的著作權和解案,獲得最終核准。數日之後,索尼音樂出版與華納查佩爾音樂,指控Anthropic未經授權使用受版權保護的歌曲訓練模型,對其提起訴訟。
這些紛爭說明溯源必須在多個層次同時運作。區塊鏈紀錄可以替作品加上時間戳、儲存密碼雜湊值、記錄授權交易,但區塊鏈無法驗證登錄作品的人是否真的擁有版權,也無法證明訓練數據集是合法取得。「輸入垃圾資料,輸出不可竄改的垃圾資料」仍是無法迴避的根本問題。
浮水印則具備另一項優勢:即便一般中繼資料被移除,隱形標記仍可伴隨內容留存。但浮水印有可能遭到破解或移除,也有不少內容一開始就未加上浮水印。區塊鏈負責留存長久紀錄,浮水印則協助把紀錄與檔案重新對應。一套可信的系統,兩者往往缺一不可。
去中心化登錄系統能否追蹤AI模型、數據集與創作作品?
更具發展潛力的方向,是建立針對模型、數據集與創作作品的去中心化登錄庫。每一項資產都配置永久識別碼、溯源紀錄、授權條款與使用規範。模型可以宣告自己獲授權使用的數據集;創作者能夠明確是否允許商用AI訓練,以及對應的授權價格。平台在匯入內容前可查詢登錄庫,審計人員也可驗證過往的權利主張。
這套機制也可實現小額分次給付。如果攝影師將作品集授權用於AI訓練,智慧合約就可以在授權使用發生時,自動分配小額報酬。模型開發商可依照數據集規模、推論運算量或是商業營收支付費用。音樂、新聞報導、圖庫照片與專業數據集,就能成為可授權的輸入來源,而非隱形的原始素材。
但技術難點在於如何公平計算貢獻度。數百萬份作品共同訓練一個模型,要替每一位創作者精準計算版稅極其困難。素材被納入訓練,不等於它就產生影響;模型輸出反映的往往是統計模式,而非可辨識的抄襲行為。任何付費機制,都需要配套歸屬規則、可靠的使用紀錄,以及爭議解決機制。
平台將是AI內容溯源的關鍵角色
平台會扮演舉足輕重的角色。社群網路、搜尋引擎、雲端服務商與數位交易市場,既能保存、顯示溯源資訊,也有可能將其刪除。AI企業掌握訓練流程與模型文件,創作者掌握個別作品,沒有任何一方可以獨自建立一套通用溯源系統。
這場新興的角力,本質不只是AI與著作權的對抗,而是由誰掌控數位創作的完整歷程。AI企業希望能大規模取得數據,並擁有可行的法律規則;創作者則追求創作歸屬、知情同意與合理報酬;平台期盼系統成本低廉、具互通性,並能抵擋人為竄改。
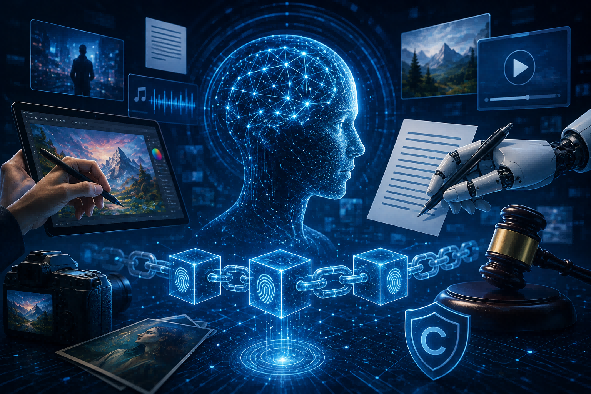
一套可信的溯源鏈,不會是單一區塊鏈、浮水印或是偵測演算法就能實現。它會是分層架構:整合密碼簽章、永久識別碼、溯源標準、授權登錄庫、平台支援與法律強制效力。
最終目標很簡單:讓AI背後的創作歷程得以被看見。
倘若這套基礎設施落地實現,網際網路將迎來新的模式:就算是人機協同創作,創作貢獻依舊可以被追蹤。溯源將成為數位信任新時代的基石,也有機會開闢創作者權益的全新市場。